複数サーバーへの反映漏れを防ぐ|デプロイ手順と1台ずつの確認方法
「さっき直してもらった件、まだ前のままなんですけど……あ、今度は直ってます」
リリースを終えてほっとしたところに、こんな連絡が来ます。自分のブラウザで何度開いても、ちゃんと直っている。キャッシュかな、と思ってしばらく様子を見ていたら、原因は2台あるWebサーバーの片方にしか反映していなかったことでした。ロードバランサーが振り分けるたびに、新しい画面と古い画面が交互に出ていたわけです。
これ、ひとりで運用していると本当によく起きます。そして、起きるのはあなたが不注意だからではありません。手順書やいつもの作業が「1台ぶん」で書かれているから、2台目・3台目が手順の外にこぼれてしまうのです。
この記事では、複数サーバーへのデプロイで反映漏れを起こさないための手順を、一緒に整理していきます。
結論:やることは4つです。①反映先のサーバーを「記憶」ではなく設定から洗い出して一覧にする、②1台ずつ手で打たず、同じ手順を全台にループで回す、③反映後はロードバランサー越しではなく、1台ずつ直接たたいて確かめる、④ファイル以外の反映(再起動・キャッシュ・バッチ用サーバー・設定ファイル)も一覧に入れる。大がかりなデプロイツールがなくても、サーバー一覧とループと確認コマンドがあれば漏れはぐっと減らせます。
なお、ここでは ssh と rsync で手作業デプロイしている現場を例にしています。コマンドの細かい挙動はOSやバージョンで違うことがあるので、まずは検証環境で試してから使ってください。
何が起きているのか:反映漏れは「手順の外」で起きる
複数サーバーの反映漏れには、だいたい決まった型があります。
- 2台目を忘れる:1台目で作業して確認し、満足してそこで終わってしまう。いちばん多い型です。
- 台数が変わったことを知らない:負荷対策で3台目が足されていたのに、手順書は2台のまま。
- Web以外のサーバーを忘れる:画面のコードは直したが、同じコードを使うバッチ用サーバーや管理画面用サーバーが古いまま。
- ファイルは入ったが、動いているのは古いまま:PHPのOPcacheやアプリの再起動が必要な構成で、1台だけ再読み込みを忘れている。
- 確認がロードバランサー越し:自分のブラウザがたまたま新しい方に振り分けられて「直った」と判断してしまう。
どれも、作業の腕前の問題ではありません。「どのサーバーに」「何を」反映するのかが、手順の中に書かれていないことが原因です。だから対策も、注意力を上げることではなく、手順の側に「全台」を書き込むことになります。
手順1:反映先のサーバーを設定から洗い出す
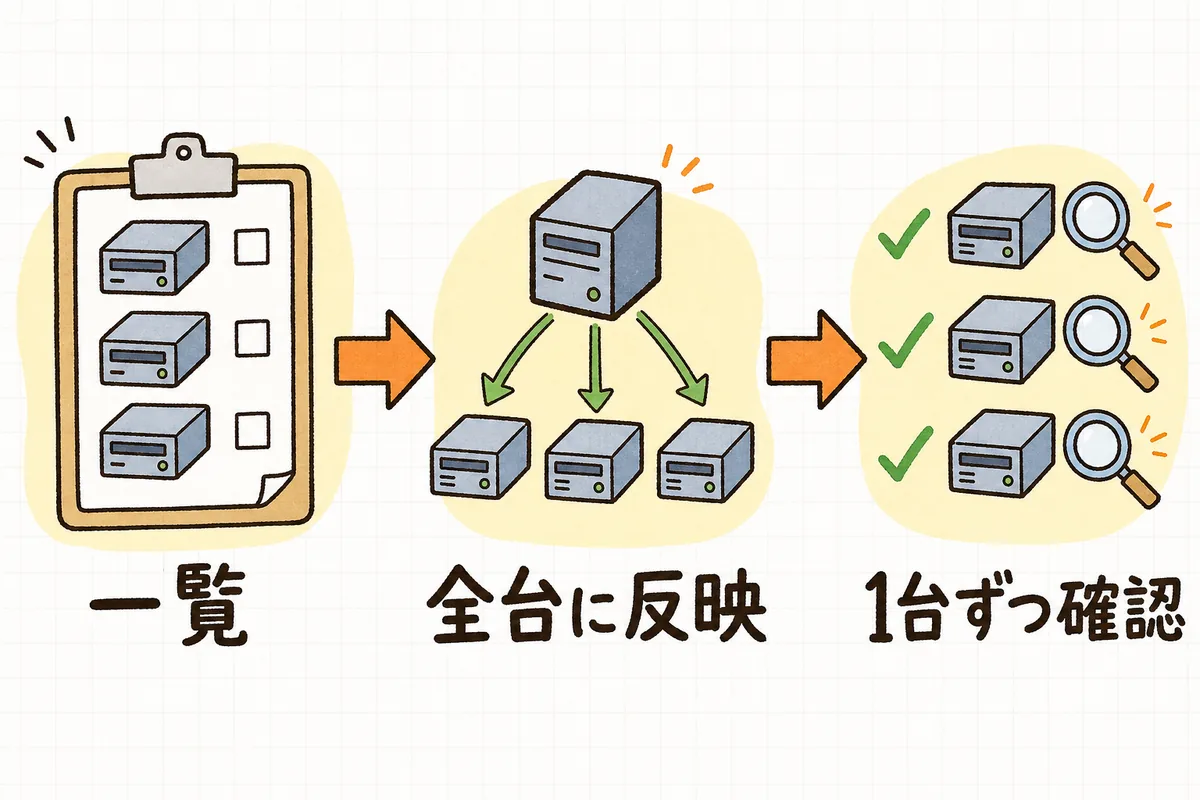
最初にやるのは、反映先のサーバーを一覧にすることです。ポイントは、自分の記憶ではなく、実際に振り分けている設定から拾うことです。
- ロードバランサーの振り分け先:クラウドのロードバランサーならターゲットグループなどの登録先、nginxなら
upstreamに並んでいるサーバー。 - バッチ・管理画面用のサーバー:同じアプリのコードを使っているサーバー。
crontabでアプリのコマンドを呼んでいるサーバーがあれば、それも対象です(cronと常駐プロセスの棚卸し)。 - 待機系・予備機:普段は使っていなくても、切り替えたときに古いコードが動き出さないように。
nginxでロードバランスしているなら、振り分け先はこんなふうに確かめられます。
# 振り分け先(upstream)に並んでいるサーバーを確かめる
sudo nginx -T 2>/dev/null | grep -A5 "upstream"
拾ったサーバーは、1行1台のテキストファイルにしておきます。これが以降の手順すべての「真実」になります。
# servers.txt(反映先の一覧。台数が変わったらここを直す)
web01
web02
batch01サーバー構成を一覧でまとめておく方法はサーバー・サービス構成を1枚にまとめる方法でも整理しています。一度作れば、次からは「一覧を開く」だけで済みます。
手順2:同じ手順を全台にループで回す
一覧ができたら、1台ずつ手でコマンドを打つのをやめて、一覧に対してループで回します。手で打つと、2台目で集中が切れたり、1台だけオプションが違ったりしやすいからです。
まずは --dry-run(-n)で、各サーバーに何が送られるかを見ます。
# まずは試し打ち:各サーバーに送られるファイルを確認するだけ(何も書き換えない)
while read -r host; do
  echo "=== $host ==="
  rsync -avn --checksum ./release/ "$host":/var/www/app/ < /dev/null
done < servers.txt台ごとに出てくるファイルの一覧が同じなら、全台が同じ状態から始められています。1台だけ一覧が長いときは、そのサーバーが以前から古いまま(または手で直された)かもしれません。そこで一度立ち止まれるのが、試し打ちのいちばんの価値です。
問題なければ -n を外して本番の反映をします。
# 本番反映:一覧の全台に同じ内容を送る
while read -r host; do
  echo "=== $host ==="
  rsync -av --checksum ./release/ "$host":/var/www/app/ < /dev/null || echo "!!! $host で失敗"
done < servers.txt
ループの中の < /dev/null は、ssh や rsync が一覧ファイルの残りを読み込んでしまい、2台目以降が黙って飛ばされるのを防ぐためのものです。ループで回したのに1台目しか反映されていなかった、というのはこの書き忘れが原因のことがあります。
--delete を付けると反映先の余分なファイルを消せますが、アップロード画像やログを置いているディレクトリまで消してしまうことがあります。使うなら、試し打ちで消える対象を必ず確認してからにしましょう。
手順3:1台ずつ「直接」たたいて確かめる
反映したら確認です。ここで大事なのは、ロードバランサー越しに見て満足しないことです。自分のブラウザがたまたま新しい方に振り分けられていれば、古い1台は見えません。
ファイルが同じかをハッシュで比べる
いちばん確実なのは、各サーバーのファイルのハッシュ値を並べて比べることです。
# 今回変えたファイルのハッシュを全台で並べる。値が1つでも違えば反映漏れ
while read -r host; do
  printf "%-10s " "$host"
  ssh "$host" "sha256sum /var/www/app/src/Order.php" < /dev/null
done < servers.txt
全台で同じ値が並べば、ファイルは揃っています。
画面・APIを1台ずつ直接見る
ファイルが揃っていても、動いているのが古いままのことがあります。そこで、各サーバーに直接リクエストを送って確かめます。curl の --resolve を使うと、ドメイン名はそのままで、行き先のサーバーだけを指定できます。
# ドメインはそのまま、行き先だけを各サーバーのIPに固定して確かめる
curl -s --resolve example.com:443:10.0.0.11 https://example.com/version.txt
curl -s --resolve example.com:443:10.0.0.12 https://example.com/version.txtここで役に立つのが、リリースごとに中身が変わる小さな確認用ファイルです。version.txt にリリース日やコミットのIDを書いて一緒に反映しておけば、「全台が今回のリリースになっているか」がひと目で分かります。確認用ファイルを外に見せたくない場合は、社内からしか見えない場所に置くか、確認後に中身を最小限にしておきましょう。
手順4:ファイル以外の「反映」も一覧に入れる
反映漏れは、ファイルのコピーだけでは終わりません。次のような作業も、サーバーごとに必要なら、一覧の全台で行うものとして手順に書いておきます。
- アプリ・PHP-FPMの再読み込み:PHPのOPcacheでファイルの更新確認を止める設定(
opcache.validate_timestamps=0)にしている場合、ファイルを置き換えただけでは古いコードが動き続けます。全台で再読み込みが必要です。 - 設定ファイル:
.envや設定ファイルを変えるリリースは、全台で同じ内容になっているかを確かめます(設定ファイル変更を安全に反映する手順)。 - キャッシュのクリア:アプリ側のキャッシュをサーバーごとに持っている構成なら、全台でクリアします。CDNやブラウザのキャッシュが原因のときの切り分けはキャッシュが原因で直らないときの切り分けで整理しています。
- バッチ・定期処理:バッチ用サーバーで動くコマンドが、新しいコードを使っているか。
1台ずつ再読み込みするなら、ロードバランサーから1台外す → 反映・再読み込み → 確認 → 戻すの順で進めると、利用者への影響を小さくできます。ただ、これは構成によって向き不向きがあるので、まずは「全台で再読み込みした」を確かめるところから始めれば十分です。
具体例:2台構成で「ときどき直っていない」
ある現場の、よくある流れです。
- 反映漏れが起きたとき:Webサーバーは
web01とweb02の2台。手順書には「サーバーにログインしてrsyncで反映」とだけ書いてあった。担当者はweb01で反映し、ブラウザで確認して完了報告。実はweb02には反映していなかった。問い合わせの「直ったり直らなかったり」から気づくまでに、半日かかった。 - 手順を変えたあと:
servers.txtに2台を書き、反映はループで一度に。反映後は、変更したファイルのハッシュを全台で並べ、--resolveで1台ずつversion.txtを確かめる。確認は2〜3分で終わり、「全台で今回のリリースになっている」と言い切って報告できるようになった。
変わったのは、担当者の注意力ではありません。「どのサーバーに」が手順の中に書かれたことです。
影響:「全台」を手順に書くと、何が変わるか
- 「直ったり直らなかったり」の問い合わせが減る:古い1台が残る状態そのものが起きにくくなります。
- 台数が増えても手順が変わらない:サーバーが増えたら一覧に1行足すだけです。
- 完了報告に自信が持てる:「全台で確認済み」と、根拠を持って言えます。
- 引き継ぎやすくなる:一覧とループがあれば、次の担当者も同じ手順で反映できます。手順書の書き方はリリース手順書の作り方でもまとめています。
明日やること
- 反映先のサーバーを一覧にする。ロードバランサーの振り分け先と、同じコードを使うバッチ用サーバーを設定から拾って、
servers.txtに書きます。 - 手順書の「サーバーにログインして」を「一覧の全台で」に書き換える。1行直すだけでも、2台目がこぼれにくくなります。
- 確認用の
version.txtを用意する。次のリリースから、リリース日やコミットのIDを入れて一緒に反映します。 - ハッシュ比較のコマンドを手順書に貼っておく。反映のたびに、全台で同じ値が並ぶかを確かめます。
- 再読み込み・キャッシュ・設定ファイルが全台で必要か確認する。自分の構成で、ファイル以外に何を反映しているかを書き出してみましょう。
今日やるのは、1の「サーバー一覧を作る」だけでも十分です。一覧があるだけで、次のリリースで「あと何台?」と自分に聞けるようになります。
複数サーバー反映の漏れ防止チェックリスト
- 反映先のサーバーを、ロードバランサーなどの設定から洗い出して一覧にしたか
- 同じコードを使うバッチ用・管理画面用・待機系のサーバーも一覧に入れたか
- 反映は一覧に対してループで回し、1台ずつ手で打っていないか
- 本番反映の前に、
--dry-runで各サーバーに送られる内容を確かめたか - ループの中で
ssh・rsyncが一覧の残りを読まないようにしたか -
--deleteを使う場合、消える対象を試し打ちで確認したか - 変更したファイルのハッシュを全台で比べ、同じ値が並んだか
- ロードバランサー越しではなく、1台ずつ直接リクエストして確かめたか
- 再読み込み・キャッシュクリア・設定ファイルの反映を全台で行ったか
- サーバーの台数が変わったとき、一覧を直す担当とタイミングを決めているか
全部できなくても大丈夫です。「一覧を作る」と「1台ずつ直接確かめる」の2つだけでも、反映漏れの多くは防げます。
よければ、こちらも
- リリース手順書の作り方|一人でも迷わない最低限の項目テンプレート:「全台で」を手順書に書き込むために。
- 本番反映前チェックリスト|作業前バックアップの取り方を一人運用で:反映前の準備をまとめて確かめたいときに。
- ロールバック手順の作り方|すぐ戻せるリリース設計を一人運用で:戻すときも、全台を同じ状態に戻すことが大切です。
- 「直したのに直らない」を切り分ける|キャッシュを疑う順番:反映漏れではなさそうなときの次の一手に。
反映漏れで冷や汗をかいた経験があるなら、それはもう「どこでこぼれるか」を知っているということです。その経験は、手順を強くするいちばん確かな材料になります。
サーバーが何台あっても、あなたが守っているのはひとつのサービスです。その全部に、同じ「直った」を届けるための一覧を、まずは1枚作ってみてください。
ほかの実務ヒントは記事一覧からどうぞ。保守運用の小さな備えを、メールでも少しずつお届けしています。