監視の平常値(ベースライン)を把握する|「いつもと違う」に早く気づく方法
「サーバーのCPU、いま40%くらいなんですけど、これって高いですか?」
障害の連絡を受けてダッシュボードを開いたとき、こんなふうに聞かれて答えに詰まったことはないでしょうか。40%。高い気もするし、昼間ならこのくらいだった気もする。結局、ほかの数字もひとつずつ見て回るうちに時間が過ぎていく——。
ここで詰まるのは、あなたの知識が足りないからではありません。比べる相手である「ふだんの値」を、どこにも控えていないだけです。監視のグラフは、平常値を知っている人にとっては「いつもと違う場所」を指さしてくれる道具になります。知らないままだと、ただの線の集まりに見えてしまいます。
この記事では、自分のシステムの平常値(ベースライン)をつかんで、1枚のメモにしておく方法を一緒に整理していきます。
結論:やることは4つです。①見る指標を5〜8個に絞る、②過去の記録から「平日昼・夜間・月末」など時間帯ごとの幅をつかむ、③その幅を1枚の平常値メモに書く、④障害のときは「いつもの幅から外れたもの」から見る。新しい監視ツールを入れなくても、sar の記録とアクセスログがあれば今日から始められます。
なお、ここでは Linux サーバーと nginx の現場を例にしています。コマンドの細かい挙動や記録の保存場所はOSやバージョンで違うので、手元の環境で確かめながら使ってください。
何が起きているのか:数字が「高いか低いか」は、ふだんとの比較でしか決まらない
監視の値には、それだけで良し悪しが決まる数字がほとんどありません。
- CPU 40%:夜間なら明らかに多いけれど、平日昼の受注ピークなら毎日のこと。
- 1時間あたり3,000リクエスト:ふだん5,000のサイトなら、むしろ減っているのが異常のサインかもしれません。
- ディスク使用率70%:半年ずっと70%なら落ち着いていますが、先週60%だったなら急いで理由を見たい数字です。
障害のときに迷うのは、この「比べる相手」がないからです。そして平常値は、落ち着いているときにしか測れません。障害の真っ最中に「ふだんはどうだったっけ」と過去のグラフを探すのは、それだけで大きな負担になります。
逆に言えば、平常値さえ手元にあれば、障害のときにやることがはっきりします。全部の数字を見るのではなく、「いつもの幅から外れた数字」だけを追えばいいのです。
手順1:見る指標を5〜8個に絞る
最初から全部の値を控えようとすると、続きません。まずは「障害のときに真っ先に見たい数字」に絞ります。一人運用なら、次のあたりから選べば十分です。
| 指標 | 何がわかるか | 取り方の例 |
|---|---|---|
| CPU使用率 | 処理が詰まっていないか | sar -u |
| ロードアベレージ | 待ち行列ができていないか | sar -q / uptime |
| メモリの空き(available) | 足りなくなっていないか | sar -r / free -h |
| ディスク使用率と増え方 | いつごろ埋まりそうか | df -h |
| 1時間あたりのリクエスト数 | 利用がいつもどおりか | アクセスログ |
| 5xxエラーの件数 | 利用者がエラーを見ていないか | アクセスログ |
| 応答時間 | 遅くなっていないか | 外形監視・アクセスログ |
| 主要バッチの所要時間 | じわじわ重くなっていないか | バッチのログ |
この表をそのまま使う必要はありません。「障害のとき、いつも最初に何を見ているか」を思い出して、それを並べるのがいちばん現場に合います。ロードアベレージの読み方に自信がなければ、ロードアベレージの見方もあわせてどうぞ。
手順2:過去の記録から「時間帯ごとの幅」をつかむ
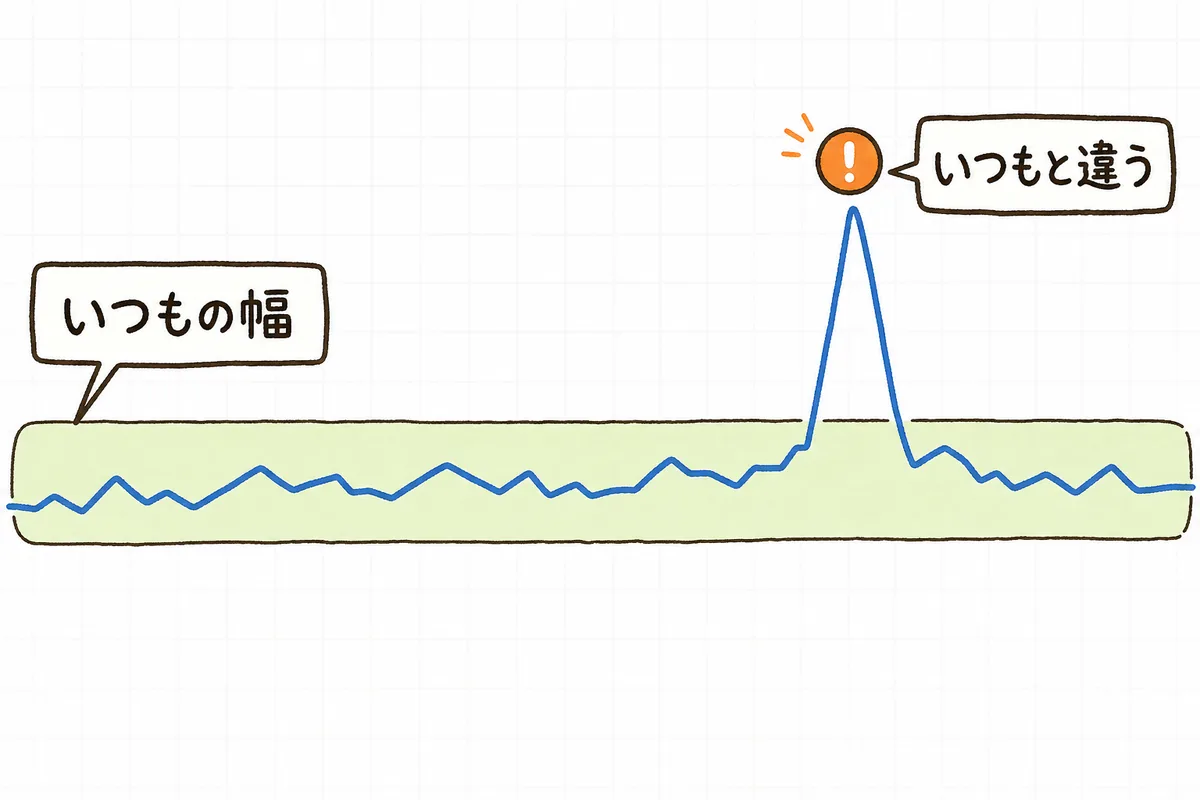
平常値は、1つの数字ではなく「幅」で持つのがコツです。しかも、その幅は時間帯によって変わります。まずは次の3つの時間帯に分けて見るところから始めましょう。
- 平日の昼(いちばん忙しい時間)
- 夜間・休日(いちばん静かな時間)
- 月末・月初など、決まって忙しくなる日(締め処理、給与計算、請求書の発行など)
sar の記録から、過去の値を読む
多くの Linux サーバーでは、sysstat の sar が10分おきなどの間隔で値を記録しています。記録があれば、過去の日の値を後から読めるので、今日から平常値をつかめます。
# 今日のCPU使用率とロードアベレージ(記録があれば一日分が並ぶ)
sar -u
sar -q

# 過去の日を読む(保存場所は環境で違う。RHEL系は /var/log/sa/、Debian/Ubuntu系は /var/log/sysstat/ が多い)
sar -u -f /var/log/sa/sa15
sar -r -f /var/log/sa/sa15
記録がない場合は、sysstat が入っていないか、収集が止まっていることがあります。Debian/Ubuntu系では /etc/default/sysstat の設定で収集が有効になっているかを確かめてください。今日から記録を始めれば、1〜2週間で平日と休日の違いが見えてきます。
アクセスログから、時間ごとのリクエスト数とエラー数を読む
利用のされ方は、アクセスログがいちばん正直に教えてくれます。nginx の標準的な形式(combined)なら、1時間ごとの件数はこう数えられます。
# 1時間ごとのリクエスト数(例:「30/Sep/2026:10」ごとに件数が並ぶ)
awk '{print substr($4, 2, 14)}' /var/log/nginx/access.log | sort | uniq -c

# 1時間ごとの5xxエラーの件数
awk '$9 ~ /^5/ {print substr($4, 2, 14)}' /var/log/nginx/access.log | sort | uniq -cログの形式を独自に変えている場合は、列の位置($4 や $9)がずれるので、1行だけ head -1 で見て合わせてください。応答時間を見たい場合は、nginx の log_format に $request_time が入っているかを確かめましょう。
「平均」ではなく「いつもこのくらいからこのくらい」で書く
数日〜2週間ぶんを見たら、時間帯ごとに「だいたいこの範囲に収まっている」を読み取ります。平均値を出すより、「平日昼はCPU 20〜35%、夜間は5%前後」のように下と上をセットで書くほうが、障害のときに判断しやすくなります。
手順3:1枚の「平常値メモ」にまとめる
つかんだ幅は、すぐ開ける場所に1枚で書いておきます。運用メモでも、サーバー構成の資料の末尾でもかまいません。
# 平常値メモ(受注システム web01)  最終更新:2026-09-30

■ CPU使用率     平日昼 20〜35% / 夜間・休日 5%前後 / 月末夕方 50%前後
■ ロードアベレージ 平日昼 1〜2(4コア) / 夜間 0.5未満
■ メモリ available 平日昼 2.5GB前後(8GB中)
■ ディスク使用率  62%(週に0.5ポイントずつ増える)
■ リクエスト数   平日10〜11時がピーク 約4,000件/時 / 深夜 200件/時前後
■ 5xxエラー     1日0〜3件
■ 主要バッチ     日次集計 2時開始 → 15分前後で終了
■ いつもと違う日 月末最終営業日の夕方(締め処理でCPU・DBが高め)ディスクのように増え方がわかる数字は、あと何か月で余裕がなくなるかも見えてきます。たとえば使用率62%で週0.5ポイント増えているなら、80%に届くまでは (80−62)÷0.5=36週、8か月ほどです。こうした見通しは、ディスク使用量の監視とログローテーションの見直しや、月次の運用報告にもそのまま使えます。
手順4:障害のときは「いつもの幅から外れたもの」から見る
平常値メモがあると、障害の初動がぐっと短くなります。メモを横に置いて、今の値と1行ずつ比べるだけです。
- メモの指標を上から順に、今の値と見比べる。
- 幅の中に収まっているものは、いったん「原因ではなさそう」と脇に置く。
- 幅から外れているものだけを深掘りする。いつから外れ始めたかをグラフで確かめると、きっかけ(リリース、バッチ、アクセス増)が見えやすくなります。
「減っている」も異常のサインです。リクエスト数がふだんより大きく少ないときは、利用者がそもそもたどり着けていない(DNS、証明書、手前の機器の不調など)可能性もあります。
平常値は、監視アラートの閾値を決めるときの土台にもなります。「平日昼の上限が35%なら、70%が10分続いたら知らせる」のように、根拠のある線が引けるようになります。閾値の決め方は監視アラートの閾値の決め方で詳しく整理しています。
具体例:「システムが遅い」と言われた日
ある現場の、よくある流れです。
- 平常値メモがなかったころ:「受注画面が遅い」と連絡を受け、まずCPUを見ると40%。高い気がしてプロセスを調べ始めたが、それらしいものが見つからない。メモリ、ディスクと順に見て回り、DBの接続数が異常に多いと気づくまでに1時間近くかかった。
- 平常値メモを作ったあと:同じ連絡を受け、メモを開いて上から比べる。CPU 40%は「平日昼 20〜35%」をやや上回る程度で、決定的な外れではない。リクエスト数も平常の範囲。ところが、メモに追加していたDBの接続数が、いつもの15前後に対して60まで増えている。最初からDB側に絞って調べ始められ、10分ほどで原因の遅いクエリにたどり着いた。
変わったのは、調べる人の腕前ではありません。「どれが、いつもと違うのか」を比べる相手が手元にあったことです。遅いクエリを見つけたあとの動き方は、スロークエリの特定と一時対処でまとめています。
影響:平常値を知っていると、何が変わるか
- 初動が速くなる:全部の数字を見て回らず、外れているものから調べられます。
- 「問題ありません」と言い切れる:「CPU 40%ですが、平日昼の範囲内です」と、根拠を添えて報告できます。
- 閾値に根拠が生まれる:なんとなく決めた閾値が、ふだんの値をもとにした線に変わります。
- じわじわ進む変化に気づける:ディスクやバッチの所要時間のように、少しずつ悪くなるものを早めに拾えます。
- 引き継ぎやすくなる:次の担当者も、メモを見れば「このシステムのふだん」がわかります。
明日やること
- 障害のときに最初に見る指標を5つ書き出す。いつも開いている画面やコマンドを思い出すだけで大丈夫です。
sar -uとsar -qを一度打ってみる。記録が出てこなければ、sysstat の収集が有効かを確かめます。- アクセスログで、1時間ごとのリクエスト数を一度数える。自分のシステムのピークの時間帯がわかります。
- 平日昼と夜間の幅を、平常値メモに1行ずつ書く。月末のような「いつもと違う日」も分かる範囲で。
- 大きなリリースや利用者の増減があったら、メモを見直す日を決める。月次の運用報告のついでがおすすめです。
今日やるのは、1の「指標を5つ書き出す」と、そのうち1つの平常値を1行メモするだけでも十分です。1行あるだけで、次に「これって高いですか?」と聞かれたとき、落ち着いて答えられます。
平常値(ベースライン)把握のチェックリスト
- 障害のときに最初に見る指標を、5〜8個に絞って書き出したか
- CPU・ロードアベレージ・メモリの過去の値を、
sarなどの記録から確かめたか - 記録が残っていない場合、収集を有効にして今日から記録を始めたか
- アクセスログから、1時間ごとのリクエスト数とピークの時間帯を確かめたか
- 5xxエラーの1日あたりのふだんの件数を把握したか
- 平常値を「平均」ではなく「下と上の幅」で書いたか
- 平日昼・夜間・月末など、時間帯ごとに分けて書いたか
- ディスクのように増えていく値は、増え方もあわせて控えたか
- 平常値メモを、障害のときにすぐ開ける場所に置いたか
- リリースや利用者の増減のあと、メモを見直すタイミングを決めたか
全部そろえなくて大丈夫です。「指標を絞る」と「幅で書く」の2つだけでも、障害のときの迷いはかなり減ります。
よければ、こちらも
- 監視アラートの鳴らしすぎを減らす|閾値の決め方と運用のコツ:平常値をもとに、鳴らすべき線を引きたいときに。
- 死活監視・外形監視・リソース監視の違い|最低限の監視設計:そもそも何を監視しているかを整理したいときに。
- ロードアベレージの見方:平常値メモに書くロードの数字を読み解くために。
- 再起動で直ったあとに確認すること:対応のあと「平常値に戻ったか」を確かめるときに。
平常値を知るのは、障害に備える地味な作業に見えるかもしれません。でも、毎日グラフを眺めてきたあなたの中には、もう「なんとなくのふだん」があるはずです。それを1行ずつ言葉にしておくだけで、次の障害の夜は少し短くなります。
まずは今日、いちばん気になっているサーバーの数字をひとつだけ、メモに書いてみてください。
ほかの実務ヒントは記事一覧からどうぞ。保守運用の小さな備えを、メールでも少しずつお届けしています。